Вернуться в каталог собеседований

Техническое Cобеседование на Аналитика Данных

Мок-собеседование на дата-аналитика с практическими задачами по Python, Pandas и SQL. После каждого блока интервьюер разбирает решения и в конце даёт рекомендации по подготовке.

Academica Courses
  • Опубликовано на YouTube:
  • Просмотры на YouTube: 11,9 тыс.
  • Лайки на YouTube: 313
Открыть на YouTube

Таймлайн

Коротко о видео

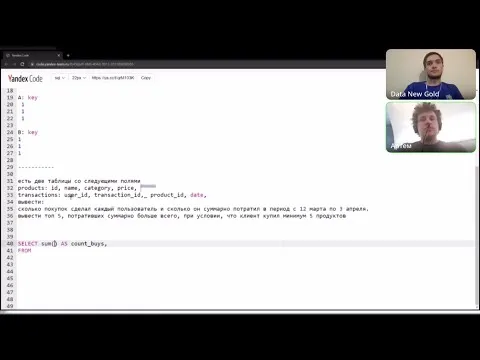
В видео показано мок-техническое собеседование студентки Акмарал на позицию дата-аналитика: интервьюер проверяет Python, Pandas и SQL, а затем разбирает ход решений. В Python обсуждают рекурсивный факториал, нормализацию пробелов и подсчёт частот слов; в Pandas — выбор строк, вычисление скорости и заполнение пропусков по типу признака. В SQL кандидат решает задачи на сортировку с LIMIT и на JOIN, GROUP BY, HAVING и MAX для сравнения текущей и исторической зарплат. В финале интервьюер, по собственному мнению, оценивает результат как хороший и советует проговаривать ход мысли, признавать ошибки и тренироваться писать код без подсказок редактора.

Затронутые темы

Что взять на заметку

  • Для рекурсивного факториала нужны базовые случаи n = 0 и n = 1 с возвратом 1 и рекурсивный возврат n * factorial(n - 1); функцию затем вызывают как factorial(100).
  • Лишние пробелы в строке удобно убирать через split() без явного разделителя и последующую сборку слов через " ".join(...); при ручной обработке важно не добавлять пробелы для пустых элементов.
  • При подсчёте наиболее частого слова полезно хранить частоты в словаре и называть переменную цикла word, а не i: это помогает не путать слово, значение и индекс.
  • При доступе к строкам DataFrame следует различать label-based loc и позиционный iloc, а также заранее проверять, существует ли требуемая позиция.
  • Скорость в км/ч для столбцов distance и time в минутах считается векторно как distance * 60 / time; интервьюер также предложил знать альтернативу через apply.
  • Для заполнения пропусков бинарные и категориальные столбцы можно заполнять модой, а числовые — средним значением или, в зависимости от распределения, медианой; присваивание результата и inplace=True не нужно использовать одновременно.
  • Для подготовки к интервью интервьюер рекомендует решать задачи по Python, Pandas и SQL без возможности сразу запустить код, проговаривать алгоритм, а неизвестный инструмент прямо обозначать вместо долгих попыток угадать ответ.

Рекомендуем посмотреть